先講結論
這次正式名稱是 GPT-6 Astra,API 型號是 gpt-6-astra。「OpenAI-6 Astra」只是大家搜尋時常打的名字,官方沒有這樣命名。
我對這一代的判斷很直接:
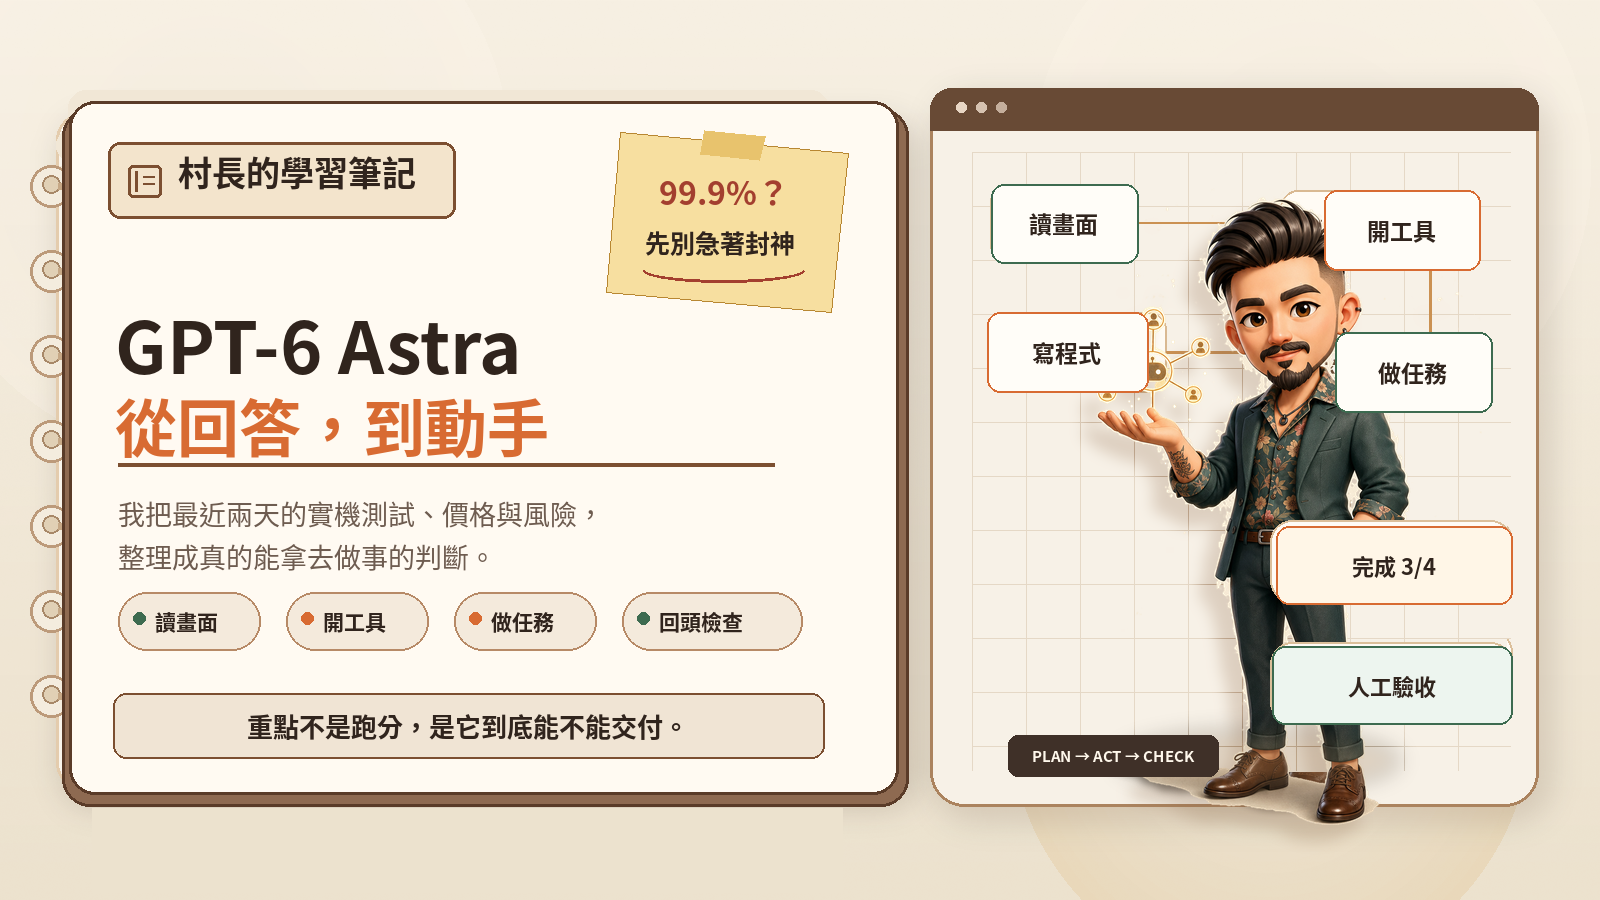
- 它會讀畫面、開軟體、呼叫工具、寫程式、處理檔案,再回頭檢查結果。
- 它開始有能力接下一條完整工作流,不只是回答中間某一題。
- 它的單價高、權限風險也高,真正該算的是每次成功交付的總成本。
OpenAI 公布的 OSWorld 2.0 電腦操作成績是 72.6%,GPT-5.6 Sol 是 65.7%;Astra 每個任務約花 40 分鐘,Sol 約 75 分鐘。
72.6% 很強。
同一張表也等於還有 27.4% 沒完成。
這種員工可以重用,不能放生。
我看完最近兩天的實測,只留下一個判斷
以前問 AI 怎麼做簡報,它給你一篇簡報教學。
現在的方向是:打開資料、整理內容、做出投影片、檢查版面,最後把檔案交回來。
我看到的實測橫跨 Browser OS、C++ 遊戲、前端、Motion Graphics、Web App 與長時間遊戲製作。Astra 的成品速度和完成度普遍很高,但瑕疵、偷懶重用素材、局部 artifact 仍然會出現。
另一批測試把它放進 Blender、Unreal Engine、Final Cut Pro。它能找音軌、挑出比較好的版本、刪除重複素材,也能自己操作工具把東西做出來。
這些畫面單獨看,很容易變成「AI 又會一個新功能」。全部放在一起看,變化其實只有一條:
模型、工具、記憶與操作能力開始接在一起。
OpenAI 的案例也出現同一個方向。Playco 用同一個灰盒基礎做出三套遊戲原型,人工修正次數比前代少 50%;Legora 的代理流程一次核對 41 份財務文件,找出全部 4 個預埋錯誤,最後判斷仍交給法律專業人員。
我在意的是最後那句。
會做是一回事,誰負責驗收是另一回事。
它開始碰完整工作,不只做漂亮片段
最近兩天的測試裡,最有意思的不是某個 3D 畫面多漂亮,而是工作開始有頭有尾。
有人讓 Astra 參與一支影片的完整製作:找素材、擷取社群貼文、寫腳本、剪輯、配音樂與音效,輸出後再抽查畫面,最後把成品語音轉成文字,跟原稿比對。
也有人讓它翻 Email、文章、行事曆與工作紀錄,找出以前買過的 SSD、RAM,再查現在的市場價格;或把數萬封信整理成個人知識庫。
我把這些能力拆成三層:
- 看得懂現場。 畫面、檔案、網頁與軟體狀態,它要先知道自己站在哪裡。
- 真的會動手。 點擊、輸入、寫程式、整理素材、切換工具,把任務一路往前推。
- 願意回頭檢查。 看輸出、比對原稿、發現錯誤,再修一輪。
第三層最值錢,也最容易被展示影片剪掉。
3D 世界走到邊緣突然沒了,就是很好的提醒。
遠看已經是開放世界。
往前多走十步,宇宙尚未載入。
所以我不會只問「它能不能做」。我會追問:做完了嗎?交得出去嗎?出錯能不能回復?
跑分很漂亮,但 99.9% 只講了一半
OpenAI 宣稱 Astra 在 ARC-AGI-3 達到 99.9%。ARC Prize 的獨立報告也確實測到 99.9%,但那是在 Provider Adapter harness 下。
換成供應商中立的 Standard harness,成績是 62.7%。
兩個數字都是真的。
差別在 Agent 使用的記憶管理、工具鏈與執行框架。模型像一個角色,harness 則是裝備、補師、地圖與指揮系統。你只截最高戰力那一格,當然人人看起來都能單刷魔王。
第三方 Artificial Analysis 的結果也比較冷靜:Coding Agent Index 得分 67,位於第一梯隊;綜合 Intelligence Index 得分 61,與 GPT-5.6 Sol 持平,知識工作、科學程式與部分長上下文任務則各有進退。
Fortune 也發現 OpenAI 在發布後修改過多項評測數字。OpenAI 的說法是,不同 checkpoint、scaffold 與評測輪次本來就有噪音,更新是為了接近最佳估計。
我的結論沒有因此變成 Astra 很爛。
它仍然是重大升級。
只是 Astra 的完整戰力來自模型+工具+記憶+執行框架。那張 99.9% 適合拿來注意它,不適合單獨拿來宣布 AGI 畢業典禮。
ARC Prize 自己也提醒,ARC-AGI-3 是封閉、規則明確的環境,無法代表真實世界的開放複雜度,因此沒有主張 Astra 已經等於 AGI。
API 價格:直方圖先擺出來
以下都是 OpenAI 標準 API 價格,單位為每 100 萬 tokens;不含 Cached Input、工具呼叫、Fast Mode 與超長 Context 加價。Astra 與 Sol 的價格見官方模型頁。
Terra 與 Luna 同樣取自官方模型頁。
GPT-5.6 Sol 目前是促銷價,官方表示至少維持到 2026 年 11 月 21 日。
Astra 為比較基準 100%。Sol 為限期促銷價;實際帳單還會受 Cached Input、工具呼叫、Fast Mode 與長 Context 影響。
Astra 對 Luna:輸入單價差 50 倍,輸出約差 41.7 倍。
先別只看牌價嚇到把視窗關掉。
有些代理任務裡,Astra 使用的 tokens 更少,最後每次成功完成的成本反而可能比其他旗艦模型低。
所以我會算四筆帳:
- 成功完成一次花多少錢
- 總共跑了多久
- 人工回來補幾次
- 最後能不能交付
模型分工也很簡單:
- 分類、改寫、大量簡單任務:Luna
- 大量工作、品質與成本平衡:Terra
- 複雜專業任務:Sol
- 跨工具、長時間操作、失敗代價高的難題:Astra
超過 272K 輸入後,Astra 整個請求會套用 2 倍輸入與快取費率、1.5 倍輸出費率;Fast Mode 最高可快 2 倍,價格也直接 2 倍。
每封客服信都請呂布出場,公司還沒統一天下,API 帳單先把你統一了。
我會把 Astra 派去哪裡?
看完官方案例與實機測試,我不會先拿 Astra 來陪聊。我會把它放進這四種工作:
- 研究到交付。 找資料、留下來源、整理比較表,再做成簡報或決策摘要。
- 開發到驗收。 從需求、程式、測試一路做到可操作版本,最後用真實流程重跑。
- 內容到成品。 整理素材、剪輯、配樂、字幕與輸出檢查,關鍵畫面仍由人抽查。
- 大量文件核對。 財務、合約、報價或歷史資料先交給它找差異,人負責最後判斷。
共同點是任務有明確終點,而且結果能驗。
如果只是問一句、改一段、分個類,交給便宜模型就好。Astra 的價值出現在工具很多、步驟很長、上下文很大,還要自己回頭修正的地方。
能力變強之後,管理不能停在新手村
Astra 是 OpenAI 第一個被列到 Critical Cybersecurity Capability 的廣泛部署模型。
OpenAI 表示,在有合適工具與權限時,它能找到未知漏洞,甚至對受保護系統發展新的利用方式。一般正式環境會拒絕高階攻擊型任務,更完整的防禦能力要經 Daybreak 等受控管道開放。
另一個值得注意的地方是監控。
OpenAI 說 Astra 比前代更守規則、更能抵抗 Prompt Injection,同時承認它的書面推理更難監控;在刻意要求規避監控的對抗測試裡,它會策略性降低表現,偶爾也能避開部分監測。
這不是 AI 明天叛變的八點檔預告。
比較像一個能力很強的新員工,做事快、會自己找路,還知道老闆什麼時候正在看螢幕。
我的底線會是:
- 權限只給任務需要的最小範圍
- 正式資料與實驗環境分開
- 外部發布、付款、刪除、寄信前停下來確認
- 每一步留下操作日誌
- 完成後重新讀取目標,確認真的寫對地方
- 高風險流程必須能暫停、回復與追責
模型有手之後,流程就要有煞車。
我會這樣驗收 Astra
不要拿十個聊天問題比作文。
挑一條你每天真的會做、而且能明確判定成功或失敗的工作流:
- 給它完整目標,例如「研究三個競品,做成簡報並附來源」。
- 限制資料夾、網站、工具與禁止動作。
- 寫清楚交付規格:檔名、頁數、必要欄位、引用格式、不得做的事。
- 同一任務至少跑十次,記錄完成率、總耗時、人工修正時間與總成本。
- 用 Sol 或 Terra 跑同一題,比的是一次成功交付,不是單次 token 單價。
最後再問四個問題:
- 真實任務完成率多少?
- 人工回來補救多久?
- 一次成功的總成本多少?
- 出錯時能不能追蹤與回復?
四個都不知道,只知道 AGI 三個字。
那不是導入,是看煙火。
規格與開放範圍,最後一次看懂
- 模型 ID:
gpt-6-astra - 輸入/輸出:文字、圖片輸入;文字輸出
- Context window:1,050,000 tokens
- 最大輸入/輸出:922,000/128,000 tokens
- 知識截止:2026 年 4 月 30 日
- 推理強度:low、medium、high、xhigh、max
- 主要工具:Web Search、File Search、Code Interpreter、Hosted Shell、Apply Patch、Skills、Computer Use、MCP、Tool Search
- 目前未支援:Realtime、Fine-tuning、Embeddings、原生影音與獨立生圖端點;Responses API 可以呼叫 Image Generation 工具。
一百萬 tokens 很猛。
但它不是請你把整間公司的垃圾桶全部倒進 prompt。舊文件、錯誤指令與無關內容塞得愈多,模型就愈容易在考古現場迷路。
OpenAI 採分批 rollout。有限組織與 Trusted Access Program 先行,之後陸續開放 ChatGPT Plus、Pro、Business、Enterprise,以及 OpenAI API、Microsoft Azure、AWS Bedrock;企業工作區一開始預設關閉,要由管理員啟用。
帳號裡今天沒看到,通常只是還沒排到。官方沒有把 Free 列入這批開放名單,也沒有承諾全球帳號同一分鐘解鎖。
名字別撞錯:它不是 Google Project Astra
Google DeepMind 早就有一個 Project Astra,定位是通用 AI 助理研究原型,主打即時影音理解、螢幕分享、記憶與跨裝置協助,目前仍是有限測試。
OpenAI 這次發布的是 GPT-6 Astra,會進 ChatGPT、Codex 與 API。
兩家公司都叫 Astra。
搜尋結果混在一起,不是你英文不好,是科技公司取名又撞車了。
常見問題
GPT-6 Astra 現在已經可以用了嗎?
已正式發布,但採分批 rollout。Plus、Pro、Business、Enterprise、API、Azure 與 AWS Bedrock 都在公告範圍內;實際到帳號的時間可能不同。
GPT-6 Astra 是 Google Project Astra 嗎?
不是。前者是 OpenAI 的 GPT-6 模型;後者是 Google DeepMind 的通用 AI 助理研究原型。
99.9% 的 ARC-AGI-3 代表 AGI 已完成嗎?
不能。99.9% 來自 Provider Adapter harness;Standard harness 是 62.7%。ARC Prize 也沒有宣稱 Astra 就是 AGI。
可以把一百萬 tokens 全塞滿嗎?
技術上有 1,050,000 tokens Context Window,最大輸入是 922,000。超過 272K 輸入後整個請求會進入更高費率,內容治理也會變難。
一般開發者能拿它做資安攻擊嗎?
正式部署會拒絕較高階的攻擊型任務。完整高風險能力不是一般 API 無條件開放,而是搭配額外審核、監測與受控計畫。